自分のブログやサイトの記事を、AIの学習に使ってほしいか。その希望を、複数のAI事業者へ同じ形式で伝えやすくする動きが出てきました。OpenAIは2026年10月30日、ウェブサイトのAI学習に関する共通信号を尊重する方針を発表しました。
対象は、サイトやメディアを運営する人たちです。企業ごとに異なる設定を管理する負担を減らすことが狙いです。ただし、OpenAIは実装を今後数か月で目指すと説明しており、発表日から新しい仕組みが全面稼働した、と受け取らないことが大切です。
何が変わる?会社ごとの設定に、共通の意思表示を加える
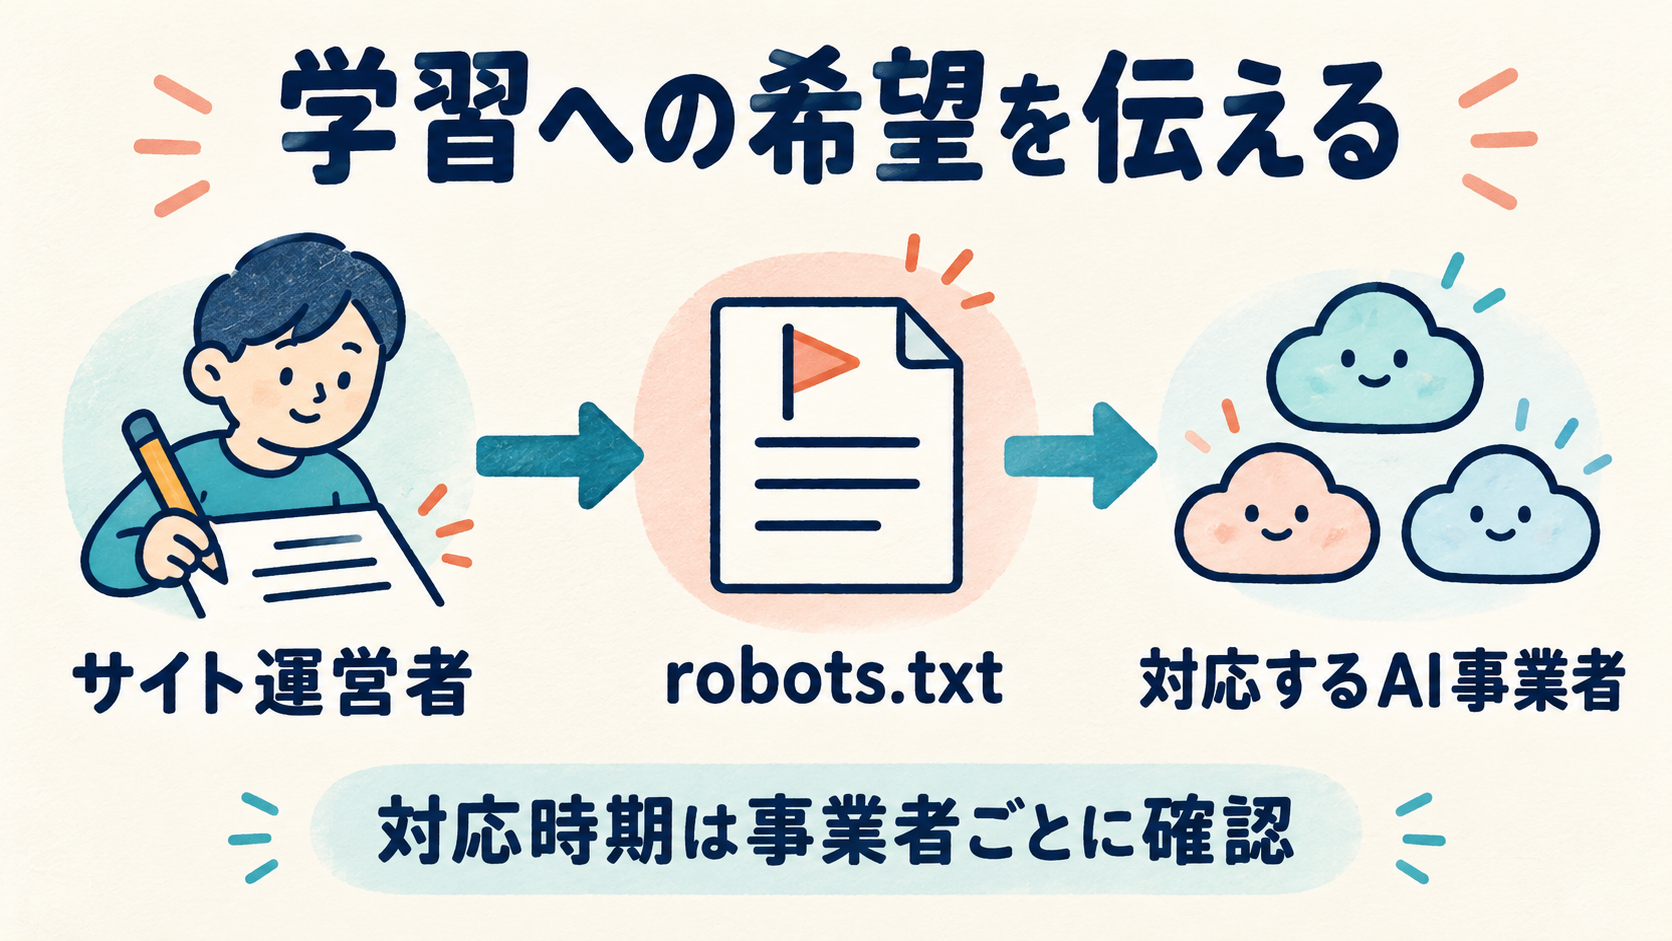
今回使う場所は「robots.txt」です。これは、サイト側が自動収集プログラムへ方針を伝えるためのファイルです。共通の信号を使えれば、参加する事業者に向けて、学習利用についての希望をまとめて表せるようになります。
OpenAIは、従来のクローラー別の設定も引き続き尊重し、新しい信号で置き換えるわけではないと説明しています。したがって、すでに設定があるサイトでも、今回の発表を理由に既存ルールをまとめて削除する、といった対応は避けたいところです。
発表からリンクされた技術提案は、特定の会社名ではなく「AI学習」という用途を表す識別子を使う考え方です。希望はサイト全体だけでなく、URLのパスごとにも表せます。なお、この資料は検討中の個人提出ドラフトで、IETFが承認した確定済み標準ではありません。
ブログやWordPressの運営者は、まず何を考える?
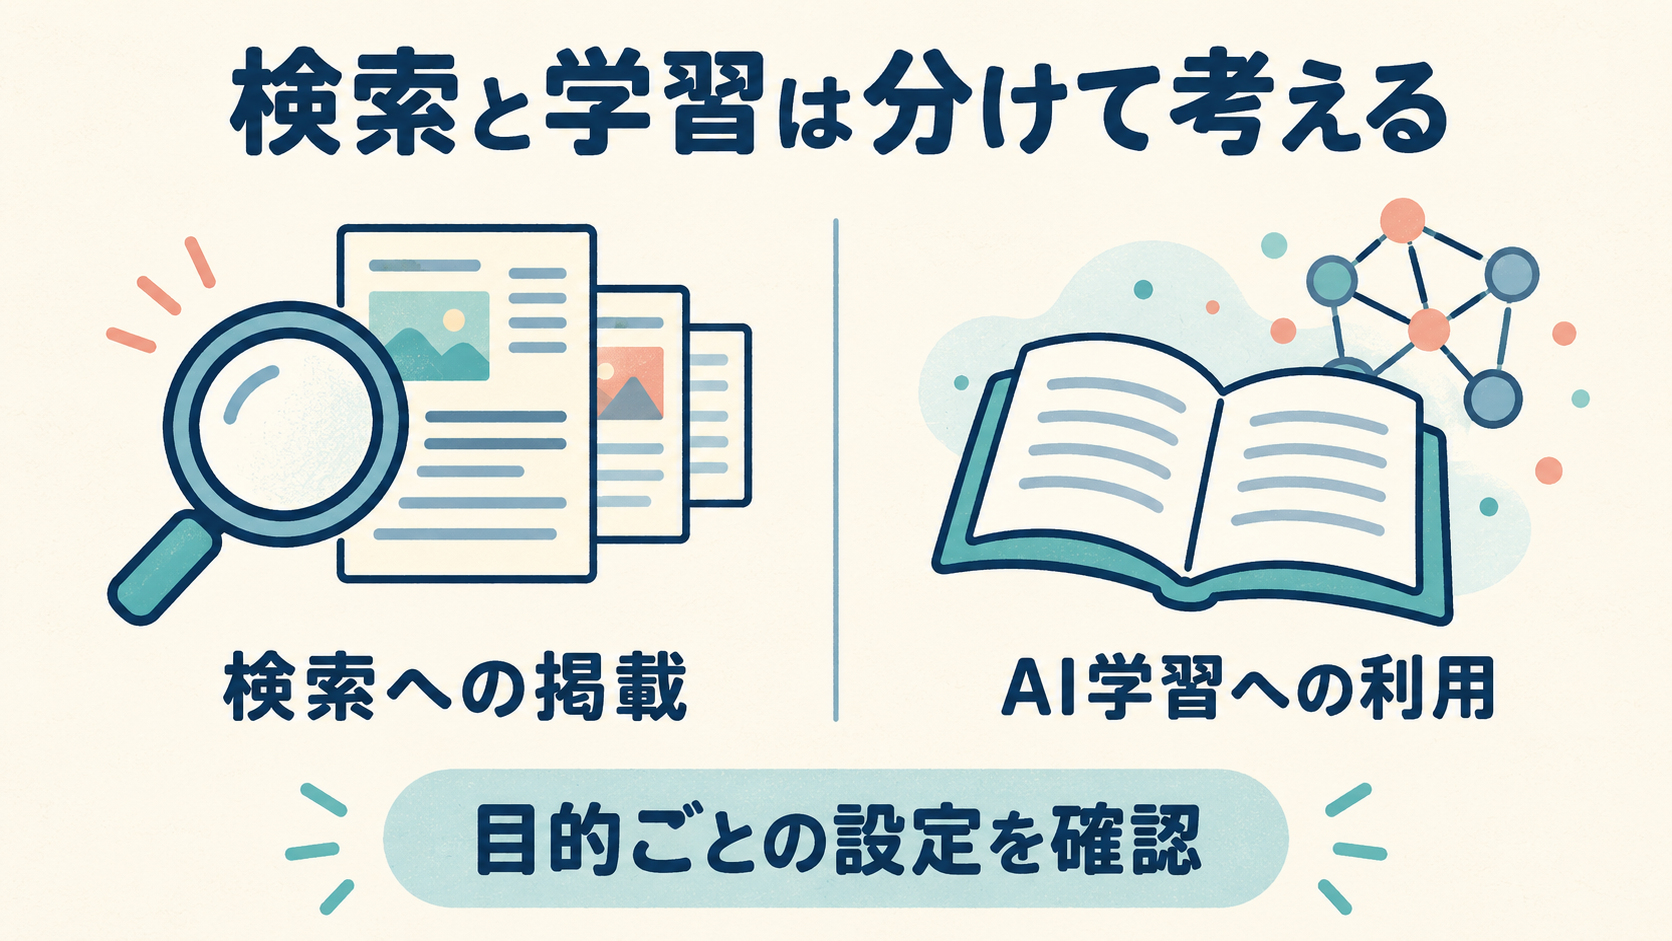
最初に整理したいのは、記事をどのように使ってもらいたいかです。たとえば「検索で見つけてもらいたい」「学習利用の扱いは別に検討したい」という希望は、分けて考えられます。今回の動きは、その判断を参加事業者に伝える方法を共通化しようとするものです。
実際に、OpenAIの既存クローラー資料では、検索結果にサイトを表示するためのOAI-SearchBotと、基盤モデルの学習に使われ得る内容を収集するGPTBotを区別しています。それぞれの設定は独立しており、検索向けを許可しながら、学習向けを拒否する組み合わせも案内されています。
WordPressで運営している場合も、まず現在どんな内容のrobots.txtが配信されているか、どの仕組みで管理しているかを把握するとよいでしょう。そのうえで、検索への掲載と学習利用の希望を整理し、対応する事業者の説明を照合する。この順序なら、意図と設定が食い違うのを減らせそうです。これは本記事の運用上の提案で、今回のニュースに合わせて特定の設定を直ちに追加すべき、という意味ではありません。
注意点:「希望を伝える」と「強制的に遮断する」は違う
技術提案では、内容の利用に関する希望と、クローラーのアクセスに関する指示を別のものとして扱っています。共通信号を置けば、あらゆるAIのアクセスが止まると考えるのは早計です。OpenAIも、自発的な取り組みとして説明しています。ほかの事業者がいつ対応するかも、個別の確認が必要です。
また、robots.txtの標準仕様であるRFC 9309は、このルールがアクセス認可の仕組みではないと明記しています。非公開にしたい情報を保護する役割まで、robots.txtだけに任せることはできません。公開範囲の管理と、公開した内容の用途を伝える作業は分けて考える必要があります。
今回の記事では、ドラフトの設定例をそのまま貼り付ける手順は紹介していません。仕様が変わる可能性と、OpenAI側の実装が今後であることを踏まえ、変更前に現行の公式資料を確認するほうが確実です。日本のサイトだけに関する個別の運用条件や、新しい仕組みの具体的な反映日時は、確認した発表では明らかになっていません。
運営者の希望を、分かりやすく伝えるために
サイト運営では、情報を広く届けたい気持ちと、用途を選びたい気持ちが同時にあります。今回の共通信号は、その希望を表す手間を減らそうとする一歩です。今すぐ全部の設定を変えるより、現在のルールと自分の方針を整理しておく。実装の詳細が出たときに、その内容と照らし合わせて判断するとよさそうです。
出典・確認日
- OpenAI公式発表:Making it easier for websites to express AI training preferences(2026年10月30日)
- Machine-Readable Training Preference Signal(2026年10月30日更新、検討中ドラフト)
- OpenAI公式資料:クローラーの種類と設定
- RFC 9309:Robots Exclusion Protocol
確認日:2026年11月1日。対応状況や技術提案は変更される可能性があります。画像はAI生成の概念図・イメージです。